KI-Agenten beherrschen: Die Prinzipien für Entscheider
TL;DR. KI-Agenten liefern mehr, als ein Mensch nachlesen kann, und trotzdem bleibt die Verantwortung beim Menschen. Beherrschbar werden sie nicht durch Vertrauen, sondern durch ein Verfahren: Risiko zuerst einschätzen, Autonomie danach bemessen, Agenten in einem abgegrenzten und beobachtbaren Raum arbeiten lassen, Fehler durch unabhängige Prüfungen erkennen, bewährtes Wissen nutzen und aus jedem Fehler und jeder Auffälligkeit eine Regel machen. Dazu ein Beispiel aus unserer eigenen Entwicklung.
Wann haben Sie zuletzt ein Ergebnis freigegeben, das Sie nicht vollständig gelesen haben? Wahrscheinlich heute. Jede Führungskraft tut das täglich: bei der Abrechnung der Steuerberaterin, beim Gutachten des Ingenieurbüros, bei der Software des Zulieferers. Wir vertrauen dabei nicht blind, sondern dem Verfahren, das hinter dem Ergebnis steht, und den Menschen, die dafür geradestehen.
Mit KI-Agenten stehen wir vor derselben Frage, nur in einer anderen Größenordnung. Agenten schreiben, rechnen, planen und programmieren in einem Tempo, bei dem niemand mehr jede Zeile nachlesen kann. Arbeiten mehrere Agenten zusammen, reichen sie sich Zwischenergebnisse weiter, und ein kleiner Irrtum am Anfang kann am Ende in vielfacher Ausfertigung auftauchen. Die Sorge, die Kontrolle zu verlieren, ist deshalb berechtigt. Die Antwort darauf ist aber nicht, auf KI zu verzichten, denn die Konkurrenz tut es nicht, sondern Kontrolle anders zu organisieren.
Nach unserer Erfahrung tragen dabei einige wenige Prinzipien. Keines davon ist neu; die meisten kennt jeder, der schon einmal mit Zulieferern, Auditoren oder sicherheitskritischen Produkten zu tun hatte. Neu ist nur, dass man sie jetzt auf Maschinen anwendet, die selbstständig handeln.
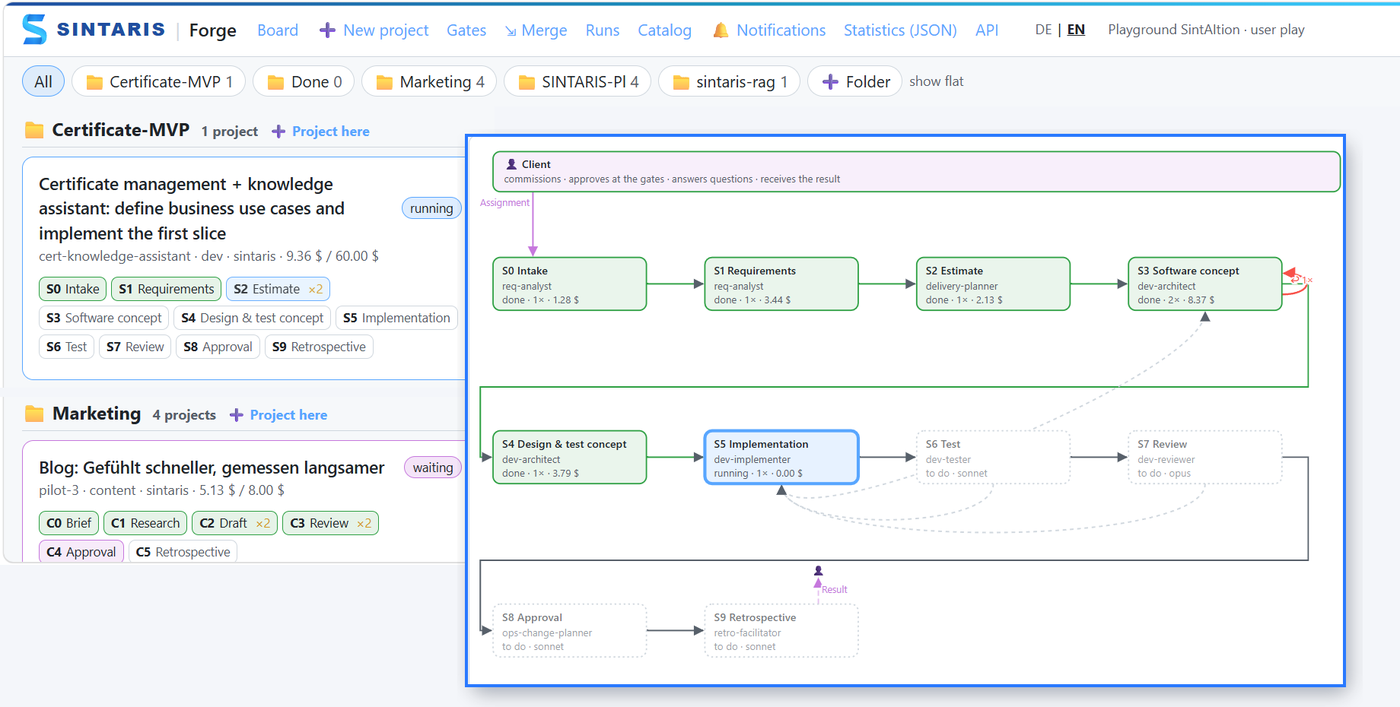
Unser Agenten-Board im Playground: echte Aufträge in festen Stufen, hier ein Projekt zur Zertifikatsverwaltung und ein Blog-Auftrag. Rechts der Ablauf eines laufenden Projekts – vom Auftraggeber über Anforderungen, Schätzung und Konzept bis zur Umsetzung; der rote Pfeil an S3 zeigt einen Rücksprung.
Die Verantwortung bleibt beim Menschen, die Kontrolle wandert in den Prozess
Eine KI kann nicht haften, ein Unternehmen schon. Daran ändert keine Technologie etwas, und der Gesetzgeber in der EU zieht diese Linie gerade eher schärfer als weicher. Wer Verantwortung trägt, ohne jedes Detail selbst prüfen zu können, braucht deshalb dasselbe, was ein Fahrzeughersteller gegenüber seinen Zulieferern braucht: klare Vereinbarungen, was geliefert wird, nachvollziehbare Prüfungen und Nachweise, auf die er sich stützen kann. Der Mensch kontrolliert nicht mehr jedes Ergebnis, sondern das Verfahren, das Ergebnisse erzeugt und prüft, und er entscheidet an den Stellen, an denen es darauf ankommt.
Erst das Risiko einschätzen, dann die Leine bemessen
Nicht jede Aufgabe verdient dieselbe Kontrolle. Eine Rechtschreibkorrektur braucht einen flüchtigen Blick, ein verbindliches Kundenangebot den prüfenden Blick auf jede Zeile, eine sicherheitsrelevante Funktion den vollen Apparat aus Prüfung, Nachweis und unabhängiger Bestätigung. Dabei lohnt es sich, zwei Fragen getrennt zu stellen: Wie riskant ist das KI-System selbst, und wie riskant ist das, was es produziert? Ein harmloses Werkzeug kann ein gefährliches Ergebnis erzeugen. Aus der Antwort folgt, wie viel Freiheit ein Agent bekommt: ob er einfach weiterarbeitet, ob er weiterarbeitet und Bescheid gibt oder ob er anhält, bis ein Mensch zugestimmt hat. Wer diese Einstufung auslässt, prüft am Ende entweder alles, was niemand durchhält, oder nichts, was sich irgendwann rächt.
Erst die Absicht, dann die Ausführung
Viele Fehler von Agenten sind in Wahrheit Fehler im Auftrag. Was nicht klar beschrieben ist, füllt der Agent mit eigenen Annahmen, und zwar mit großer Überzeugung. Deshalb steht am Anfang ein Auftrag, der sagt, was erreicht werden soll, woran man erkennt, dass es erreicht ist, und was ausdrücklich nicht dazugehört. Diese Absicht ist später der Maßstab, an dem jede Prüfung ansetzt. Ohne sie gibt es nichts, wogegen man prüfen könnte, außer dem eigenen Bauchgefühl.
Freiraum mit Zaun
Agenten sollen selbstständig arbeiten dürfen, sonst verschenkt man ihren Nutzen. Aber sie arbeiten in einem abgegrenzten Raum, in dem ein Fehler keinen echten Schaden anrichten kann: ohne Zugriff auf Produktivsysteme, ohne Zugangsdaten, mit einem Ergebnis, das immer ein Vorschlag ist und nie eine vollendete Tatsache. Wichtig ist dabei, wo die Grenzen stehen. Eine Anweisung im Auftrag ist eine Bitte, eine technische Sperre ist eine Grenze, und was nicht verhandelbar ist, gehört in die zweite Kategorie.
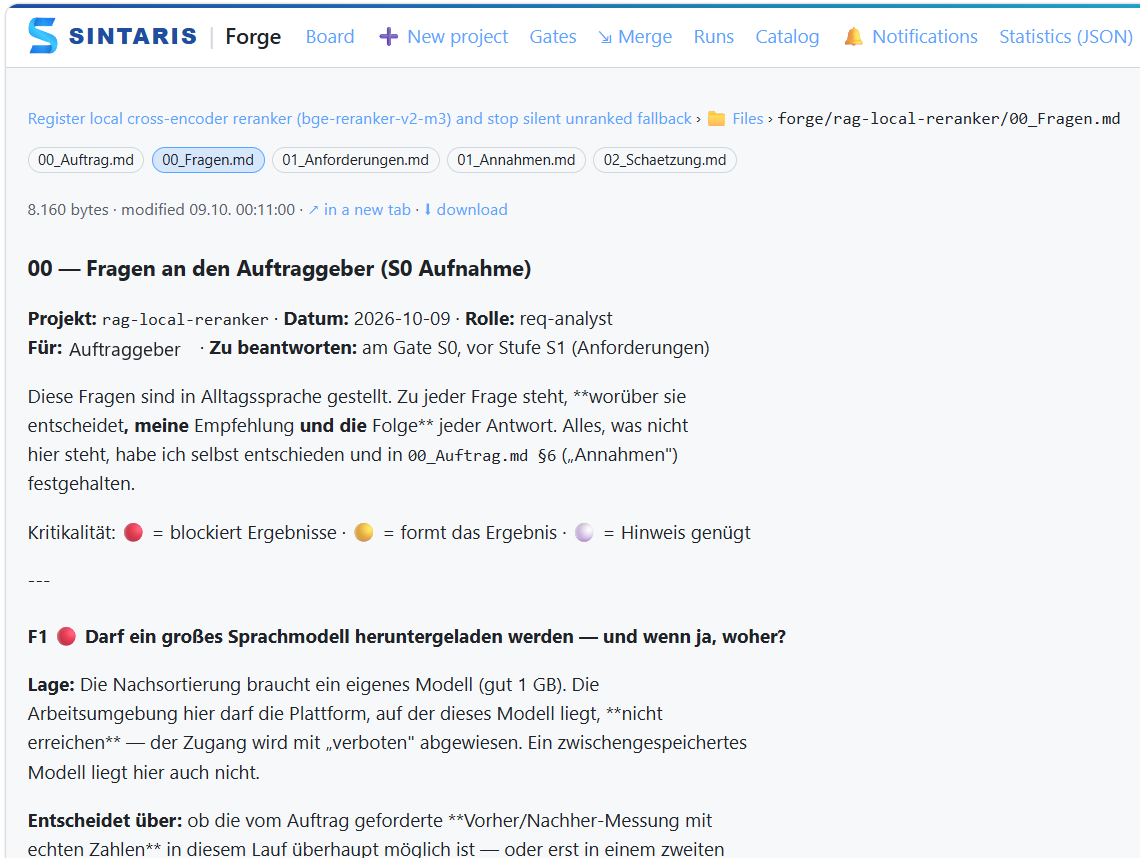
Der Zaun in Aktion: Die Arbeitsumgebung durfte die Plattform mit dem benötigten Modell nicht erreichen. Der Agent hat die Sperre nicht umgangen, sondern die Frage an den Auftraggeber gestellt, mit Lage, Folgen und Kritikalität.
Sehen, was passiert
Man kann nur steuern, was man sieht. Jeder Schritt eines Agenten, jede Entscheidung, jede Minute und jeder Euro sollte sichtbar sein, im Idealfall live auf einer Übersicht, die auch ein Nicht-Techniker versteht. Diese Sicht ist nicht nur Kontrolle, sie ist auch die Grundlage für alles Lernen, denn ohne Aufzeichnung gibt es später nichts, woraus man lernen könnte. Und es braucht einen Not-Aus, der wirklich funktioniert.
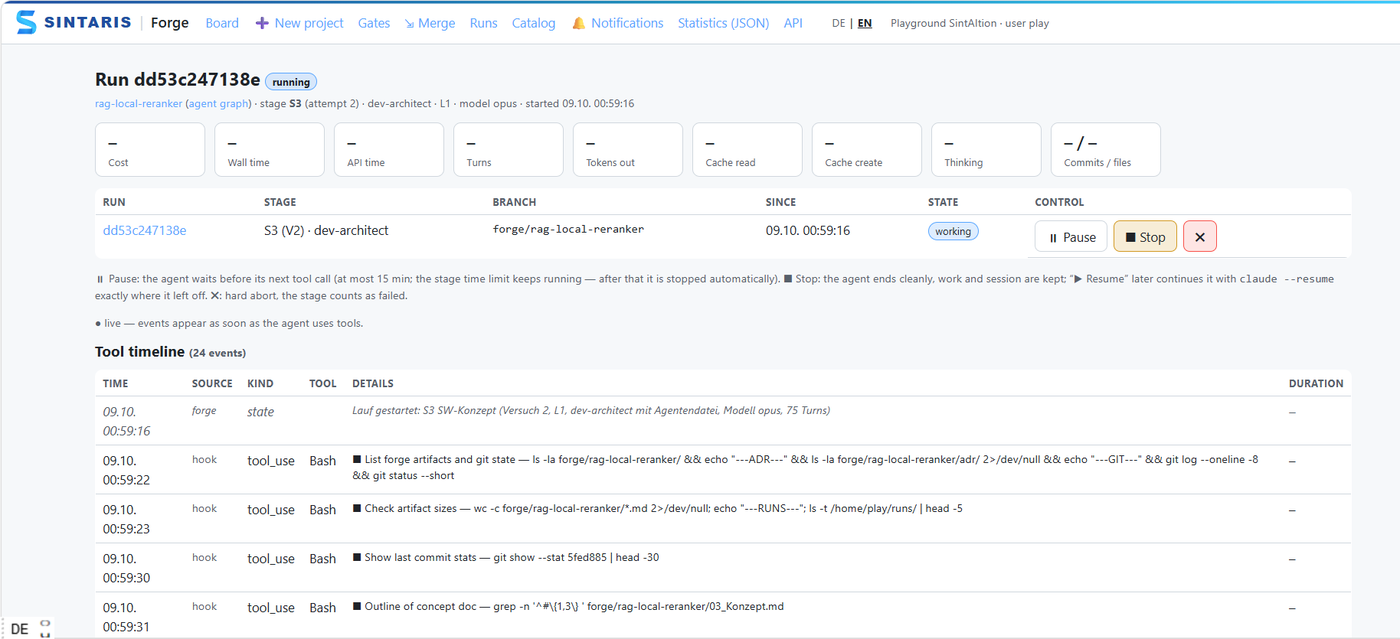
Jeder Werkzeugaufruf eines Agenten erscheint live in der Zeitachse; Pause, Stop und Abbruch sind jederzeit einen Klick entfernt.
Prüfen durch Erkennen, nicht durch Vertrauen
Einem Agenten zu vertrauen ist keine Strategie. Beherrschbar wird er, weil die Prüfungen dahinter seine Fehler mit hoher Wahrscheinlichkeit finden. Bewährt hat sich ein Dreiklang: feste, unbestechliche Regeln und Tests, die immer gleich urteilen; eine zweite Instanz, gern auch ein weiterer Agent, die das Ergebnis gegen den ursprünglichen Auftrag prüft und jede Aussage belegen muss; und ein Mensch, der an wenigen, klar festgelegten Stellen entscheidet. Die zweite Instanz darf Zweifel äußern und eskalieren, entscheiden darf sie nicht.
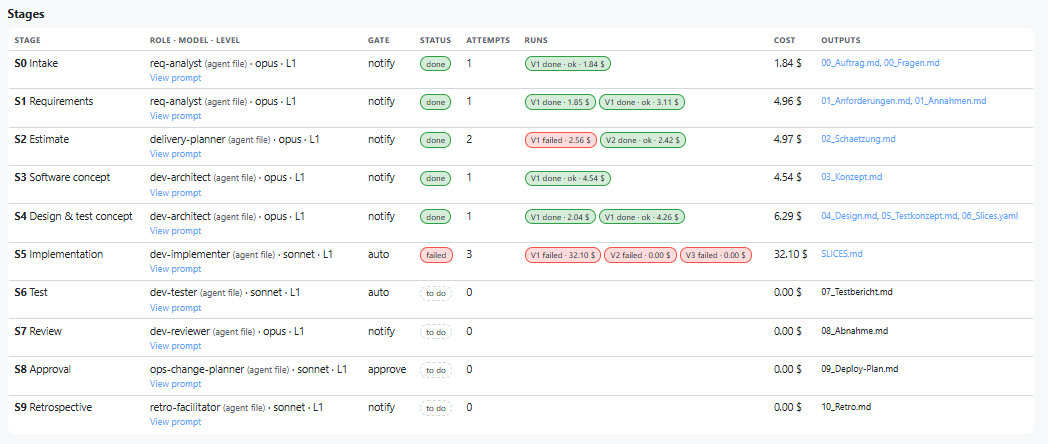
Jede Stufe wird geprüft, bevor die nächste beginnt: Grün heißt bestanden, Rot nicht bestanden. Hier ist die Umsetzung (S5) dreimal durch die Prüfung gefallen, und es geht erst nach einer Entscheidung weiter.
Dass solche Prüfungen kein Bremsklotz sind, legen Daten von Databricks nahe: Nach dem Bericht „State of AI Agents" (Januar 2026), der auf Nutzungsdaten von über 20.000 Kundenorganisationen beruht, bringen Unternehmen mit KI-Governance-Werkzeugen mehr als zwölfmal so viele KI-Projekte in den Produktivbetrieb, Unternehmen mit Evaluierungswerkzeugen fast sechsmal so viele [2]. Das ist eine Korrelation aus Herstellerdaten und kein Beweis für Ursache und Wirkung, aber sie zeigt in dieselbe Richtung wie der Befund des MIT.
Bewährtes Wissen nicht neu erfinden
Branchennormen, Prüfvorschriften und Regelwerke sind geronnene Erfahrung aus Jahrzehnten von Unfällen, Rückrufen und Audits. Sie gelten auch dann, wenn ein Ergebnis von einer KI stammt, und sie liefern oft schon die Antwort auf die Frage, wie tief geprüft werden muss. Dasselbe gilt im Kleinen für das Wissen im eigenen Haus: Projektregeln, Checklisten und das, was langjährige Kolleginnen und Kollegen wissen, gehören aus deren Köpfen in die Prüfkette, wo jeder Agent sie vor jeder Arbeit vorgelegt bekommt.
Aus Fehlern und Auffälligkeiten lernen
Dieses Prinzip unterschätzen die meisten, und es ist vielleicht das wichtigste. Ein System aus Menschen und Agenten wird nicht dadurch beherrschbar, dass es keine Fehler macht, sondern dadurch, dass es denselben Fehler kein zweites Mal macht.
Wie entscheidend das ist, zeigt eine viel zitierte Studie des MIT (Project NANDA, 2025). Trotz Investitionen von 30 bis 40 Milliarden Dollar erzielen nach dieser Auswertung 95 Prozent der Organisationen keinen messbaren Ertrag aus generativer KI, und nur 5 Prozent der maßgeschneiderten Lösungen schaffen es in den Produktivbetrieb. Die Hauptursache sehen die Autoren weder in den Modellen noch in der Regulierung, sondern im Lernen: Die meisten Systeme behalten kein Feedback, passen sich nicht an den Kontext an und werden mit der Zeit nicht besser. Eine befragte Person aus einer Kanzlei bringt es auf den Punkt: Das Werkzeug wiederhole dieselben Fehler und brauche in jeder Sitzung wieder den ganzen Kontext [1]. Die Zahlen beruhen auf Interviews und Umfragen, und die Autoren nennen sie selbst eher eine Richtung als eine exakte Messung. Die Richtung ist aber eindeutig, und sie gilt für das Zusammenspiel von Mensch und Agent genauso wie für das Werkzeug allein.
Dazu muss man zuerst hinschauen, und zwar nicht nur auf das, was schiefgeht, sondern auch auf das, was auffällt. Ein Lauf, der doppelt so lange dauert wie sonst. Ein Agent, der eine Aufgabe anders löst als verlangt. Eine Prüfung, die seit Wochen nie anschlägt, was eher verdächtig als beruhigend ist. Solche Auffälligkeiten sind oft die ersten Anzeichen eines Problems, lange bevor ein Fehler sichtbar wird.
Dann muss man das Gelernte so festhalten, dass es wirkt. Eine Anekdote im Gedächtnis eines Mitarbeiters hilft beim nächsten Mal wenig, vor allem wenn dieser Mitarbeiter im Urlaub ist. Eine Lehre in festem Format dagegen, mit dem Zusammenhang, dem Problem, der Ursache und der Regel, die daraus folgt, lässt sich wiederfinden, prüfen und beim nächsten passenden Auftrag automatisch wieder vorlegen, dem Menschen wie dem Agenten. Wird eine Lehre wichtig genug, wandert sie weiter: von der Notiz zur Regel, von der Regel zur automatischen Prüfung, die den Fehler künftig von selbst abfängt. Jede Ablehnung an einem Freigabepunkt ist dabei ein Geschenk, denn der Kommentar des Menschen, warum etwas nicht passt, ist die wertvollste Anweisung, die ein Agent bekommen kann.
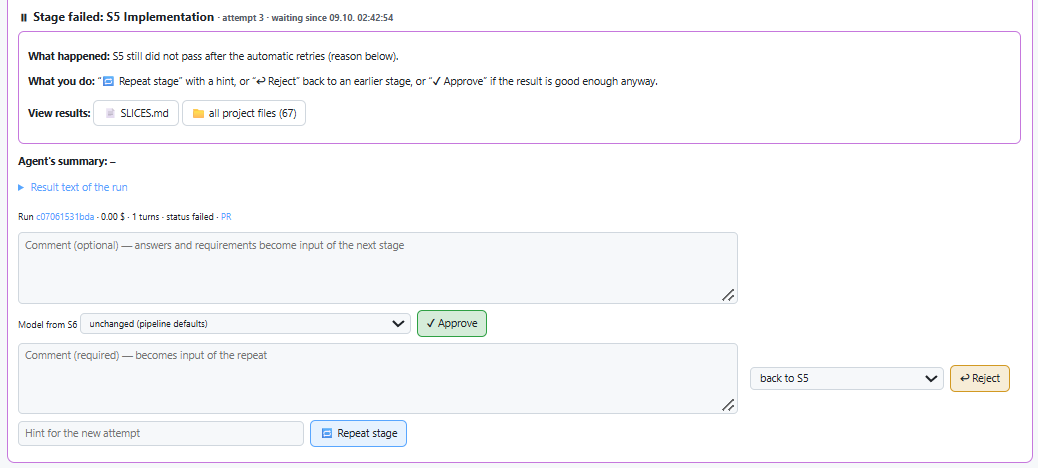
Nach drei gescheiterten Versuchen hält das System an. Der Mensch entscheidet: annehmen, zurückweisen oder mit einem Hinweis wiederholen. Der Kommentar wird zur Eingabe des nächsten Versuchs.
Und schließlich muss ein Mensch entscheiden, welche Lehren gelten. Nicht jede Beobachtung ist eine Regel, und ein Wissensspeicher, in den ungeprüft alles hineinläuft, wird schnell zum Rauschen.
Der Mensch muss in Übung bleiben
Die beste Kontrolle nützt nichts, wenn am Freigabepunkt nur noch abgenickt wird. Je zuverlässiger ein System scheint, desto größer die Versuchung, ihm einfach zu glauben, und desto schwerer fällt es im Ernstfall, einzugreifen. Fachleute kennen dieses Problem seit Jahrzehnten aus der Automatisierung von Flugzeugen und Kraftwerken. Regelmäßige, echte Entscheidungen an den Freigabepunkten sind deshalb kein Bürokratieaufwand, sondern Training für den Tag, an dem es darauf ankommt. Dazu gehört auch, die Menschen zu schulen, die diese Entscheidungen treffen, damit sie wissen, was ein Agent kann und wo er typischerweise danebenliegt.
Wie das bei SINTARIS aussieht
Das SINTARIS-Team arbeitet in der eigenen Entwicklung nach genau diesen Prinzipien. Unsere Agenten arbeiten in einem abgeschotteten Arbeitsbereich, unserem „Playground", ohne Zugriff auf Produktivsysteme. Jeder Auftrag durchläuft feste Stufen, von der Analyse über Umsetzung, Test und Prüfung bis zur Freigabe, und an jeder Stufe ist festgelegt, ob der Agent weiterarbeitet, Bescheid gibt oder auf einen Menschen wartet. Jeder Schritt, jede Minute und jeder Cent sind auf einer Übersicht sichtbar, und das Ergebnis ist immer ein Vorschlag, den ein Mensch annimmt oder ablehnt.
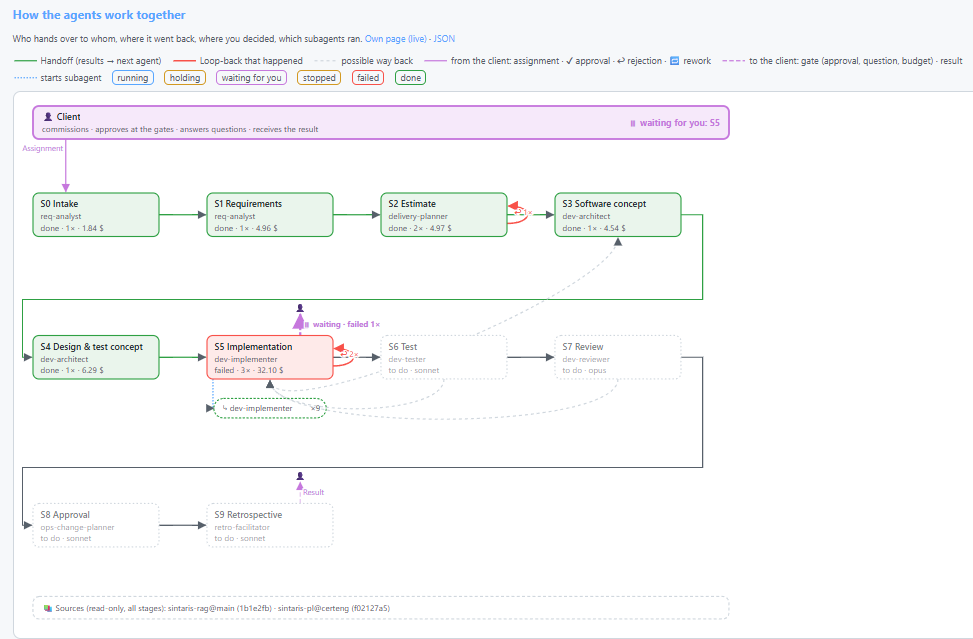
Ein laufendes Projekt zur Zertifikatsverwaltung: S0 bis S4 bestanden, Rücksprünge (rot) sichtbar, Teilagenten in der Umsetzung. Die Umsetzung ist gescheitert, das Projekt wartet auf den Auftraggeber („waiting for you: S5“).
Zwei Erlebnisse aus der Anfangszeit zeigen, warum sich das lohnt. Beim ersten echten Pilotauftrag sollte ein Agent eine fehlende Komponente nachtragen. Er stellte fest, dass die eigentliche Ursache woanders lag, löste das Problem auf anderem Weg und dokumentierte, warum. Formal hatte er den Auftrag nicht erfüllt, inhaltlich vermutlich besser gelöst. Ob das gewollt ist, kann keine Maschine entscheiden, und genau deshalb lag die Freigabe bei einem Menschen. Das zweite Erlebnis betraf uns selbst: Die lückenlose Aufzeichnung deckte zwei Fehler in unserem eigenen Steuerungssystem auf, die sonst wohl tagelang unbemerkt geblieben wären. Auch der Beobachter braucht einen Beobachter.
Lernen ist bei uns fester Teil des Ablaufs. Schon beim Aufbau des Arbeitsbereichs traten Hürden auf, die keine Anleitung vorhergesehen hatte, und jede davon wurde als Lehre im festen Format festgehalten. Jede Stufe eines Auftrags endet mit einem Abschnitt, was daraus zu lernen ist, und jeder Auftrag mit einem kurzen Rückblick, der Schätzung und tatsächlichen Aufwand vergleicht. Ein Mensch prüft diese Vorschläge und nimmt sie an oder verwirft sie. Unser Betriebsprotokoll umfasst inzwischen weit über hundert solcher Lehren, und sie fließen Schritt für Schritt in die Regeln und Prüfungen ein, die unsere Agenten vor jeder Arbeit vorgelegt bekommen.
Keines dieser Prinzipien verlangt teure Spezialsoftware oder ein großes Forschungsbudget. Was sie verlangen, ist die Entscheidung, wer an welcher Stelle was freigibt, und die Disziplin, aus jedem Fehler eine Regel zu machen. Deshalb zum Schluss eine Frage, die sich ganz ohne KI beantworten lässt: Wann hat Ihr Unternehmen zuletzt aus einem Fehler eine Regel gemacht, die heute noch gilt? Wenn die Antwort lange auf sich warten lässt, ist das der beste Ort, um anzufangen, mit Agenten oder ohne.
Quellen
- MIT Media Lab, Project NANDA (Challapally, A., Pease, C., Raskar, R., Chari, P.): The GenAI Divide: State of AI in Business 2025, Juli 2025: https://mlq.ai/media/quarterly_decks/v0.1_State_of_AI_in_Business_2025_Report.pdf
- Databricks: 2026 State of AI Agents: https://www.databricks.com/resources/ebook/state-of-ai-agents · Zusammenfassung: Enterprise AI agent trends: Top use cases, governance + evaluations and more, 27.01.2026: https://www.databricks.com/blog/enterprise-ai-agent-trends-top-use-cases-governance-evaluations-and-more